Vom 24. Juli bis zum 7. Oktober 2026 hat Anthropic fünf Claude-Modelle veröffentlicht: Opus 5, Fable 5.1, Opus 5.5, Sonnet 5.5 und Haiku 5.5. Opus 5.5 kostet laut Anthropic im typischen Einsatz 40 Prozent weniger als Opus 5. In den Benchmarks liegt es bei Terminal-Bench, FrontierCode, CursorBench, GDPval-AA und WANDR vorn, bei AutomationBench knapp hinter GPT-6 Astra. Dazu kommen neue Funktionen in den Apps (Cowork und Chat in einem), in der API (Computer Use und Browser Use stabil, Kompaktierung auf Abruf) und in Claude Code 2.1.301.

Opus 5.5 kostet laut Anthropic im typischen Einsatz 40 Prozent weniger als Opus 5. Claude wird billiger, und Haiku 5.5 rechnet bei kurzen Prompts mit 10 Cent je Million Token. Zwischen dem 24. Juli und dem 7. Oktober 2026 hat Anthropic fünf neue Claude-Modelle veröffentlicht. Dazu kamen Neuerungen in den Apps, in der API und in Claude Code. Dieser Überblick sortiert das Wichtigste und zeichnet die Benchmark-Diagramme von Opus 5.5 mit den Daten aus Anthropics Ankündigung nach.
Das Wichtigste in Kürze
- Opus 5.5 ist 40 Prozent billiger. Das gilt laut Anthropic für den typischen Einsatz im Vergleich zu Opus 5. Sonnet 5.5 rechnet mit $2 / $10, Haiku 5.5 mit $0.10 / $0.50 je Million Token.
- Opus 5.5 führt in 7 von 9 Tests. Bei FrontierCode erreicht es den Spitzenwert zu etwa einem Fünftel der Kosten.
- Cowork und Chat sind jetzt ein Claude. Die Arbeitsumgebung läuft auf Web und Mobil, Max- und Team-Pläne bekommen monatliche API-Credits.
- Computer Use und Browser Use sind stabil. Neu sind die Kompaktierung auf Abruf (Beta) und Claude Code 2.1.301.
- Bis 30. November umstellen. Dann läuft die Modell-ID
claude-sonnet-4-5-20250929aus.
Die fünf Modelle auf einen Blick
claude-opus-5claude-fable-5-1claude-opus-5-5claude-sonnet-5-5claude-haiku-5-5Ein Fable-Token kostet so viel wie 100 Haiku-Token. Die drei Karteikarten zeigen die Modelle auf drei Arten gegeneinander.
Alle fünf Modelle fassen 1 Million Token Kontext und liefern bis zu 128 000 Token Ausgabe. Mythos 5.1 ist baugleich mit Fable 5.1, steht aber nur den Teilnehmern von Project Glasswing offen. Bei Fable 5.1, Opus 5.5 und Sonnet 5.5 lässt sich das Denken nicht mehr abschalten. Ein erzwungener Tool-Aufruf über tool_choice mit any oder tool ist bei diesen Modellen nicht möglich.
Opus 4.1 wurde am 5. August abgeschaltet. Für Sonnet 4.5 hat Anthropic am 30. September das Ende zum 30. November angekündigt.
Opus 5.5: das Flaggschiff wird billiger
Opus 5.5 ist das erste Modell der Claude-5.5-Familie. Laut Anthropic arbeitet es auf dem Niveau von Fable 5.1 und kostet im typischen Einsatz 40 Prozent weniger als Opus 5. Die Preisliste erklärt einen Teil davon: Input und Output sind mit $4 und $20 um 20 Prozent günstiger, und das Lesen aus dem Cache kostet $0.20 statt $0.50. Den Rest holt das Modell über weniger Token pro Aufgabe herein. Die Ausgabe läuft nach Anthropics Angaben ausserdem mehr als 30 Prozent schneller.
Zudem liefert der Schnellmodus bis zum 2,5-Fachen der Geschwindigkeit und kostet $8 und $40 pro Million Token. Seit dem 15. Oktober ist er kein Vorschauangebot mehr. Abonnenten bekommen höhere Fünf-Stunden-Limits und einen Rate-Limit-Reset, den sie aufsparen können.
Dabei kommt Opus 5.5 mit Schutzmassnahmen, wie sie bisher Fable 5.1 hatte. Bei Cybersecurity, Biologie und Destillation weicht das System auf ein anderes Modell aus; die meisten Cybersecurity-Aufgaben gehen an Opus 4.8. Verifizierte Fachleute können über ein Verifizierungsprogramm mehr Spielraum bekommen. Opus 5.5 gibt es mit Zero Data Retention. Für Fable 5.1 verlangt Anthropic dagegen eine Aufbewahrung von 30 Tagen.
Neu in den Apps
- 7.7.: Cowork läuft auf Web und Mobil, der Microsoft-365-Connector bekommt Schreibwerkzeuge.
- Am 9. und 10.7.: Die Funktion Reflect liefert einen Monatsrückblick, Memory besteht nun aus einzelnen, kategorisierten Einträgen statt aus einer Tageszusammenfassung.
- 16.9.: Cowork und Chat sind ein Claude. Design, Slides und Docs lassen sich aus jedem Gespräch heraus starten.
- 10., 15. und 25.9.: Smart Reports (Beta, Enterprise), ein Salesforce-Plugin (Beta) und die Einreichung von Plugins über ein Entwicklerportal.
- 7.10.: Max- und Team-Pläne bekommen monatliche API-Credits.
Neu für Entwickler
In der API sind seit Mitte August Computer Use, Browser Use, die Files API und Agent Skills aus der Beta heraus. Der Effort-Parameter mit den Stufen low bis max ist seit dem 24. Juli stabil. Als Beta kamen die Kompaktierung auf Abruf (14.9.), Tools, die sich mitten im Gespräch ändern lassen (22.9.), Dynamic Workflows für Managed Agents (9.10.) und ein OpenTelemetry-Export (14.10.).
So steht Claude Code inzwischen auf Version 2.1.301. Hooks für Befehle und HTTP können eine Aktion jetzt mit onFailure: "block" blockieren. Das Agent-Werkzeug nimmt einen effort-Parameter an, und Workflow-Agents laufen auf Wunsch mit einem eigenen Modell. Lange Sitzungen mit mehr als 200 000 Token komprimiert Claude Code nach etwa 54 Minuten Pause von selbst.
Die Benchmarks von Opus 5.5
Opus 5.5 liegt in sieben von neun Tests vorn. Dazu kommt der Preis: Dieselbe Aufgabe kostet im Standardbetrieb (Medium) oft nur einen Bruchteil. Die erste Karteikarte zeigt alle vier Vergleiche in einem Bild, die zweite je Test das Ergebnis und die Kosten je Aufgabe.
Dabei gilt der Vorsprung gegenüber dem jeweils besten anderen Modell im Vergleich, auch gegenüber den eigenen Vorgängern. Bei Terminal-Bench 4.0 ist er mit 8,5 Punkten am grössten, bei CursorBench liegen 6 Punkte zwischen Opus 5.5 und dem Zweiten.
Vorsprung von Opus 5.5 auf das beste andere Modell der jeweiligen Zeile, in Prozentpunkten (bei GDPval-AA in Elo). Rechts vom Strich ist Opus 5.5 besser, links schlechter.
Zwei Niederlagen stehen dem gegenüber: AutomationBench (knapp) und Terminal-Bench-Science (deutlicher, aber mit grosser Messunsicherheit). Die übrigen Abstände sind klein. Anthropic weist selbst darauf hin, dass Abstände auf diesem Niveau weniger aussagen. Im eigenen Einsatz sei der Abstand zwischen Opus 5.5 und Fable 5.1 kleiner, als die Werte nahelegen.
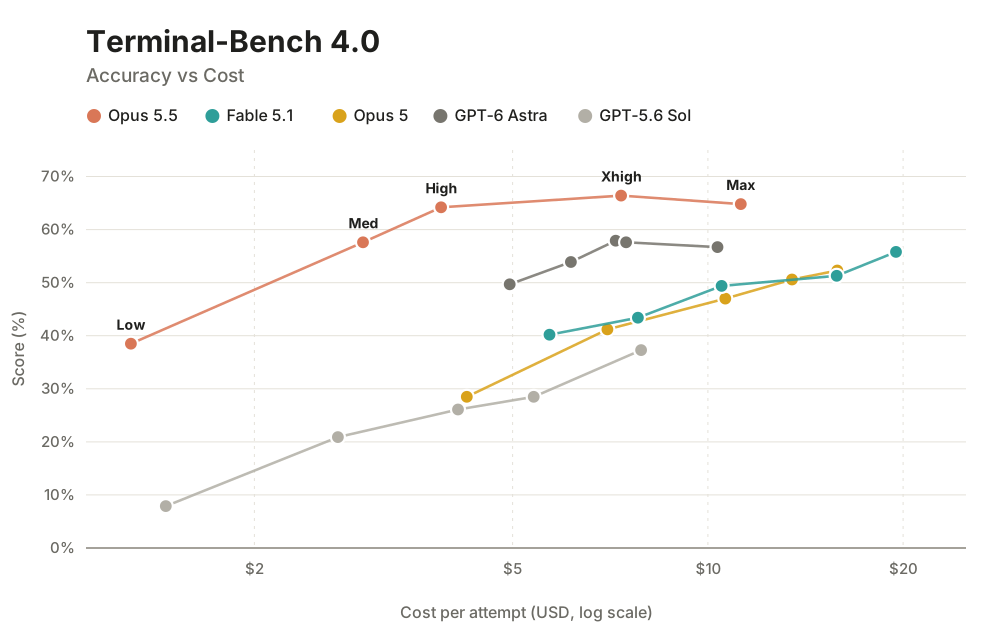
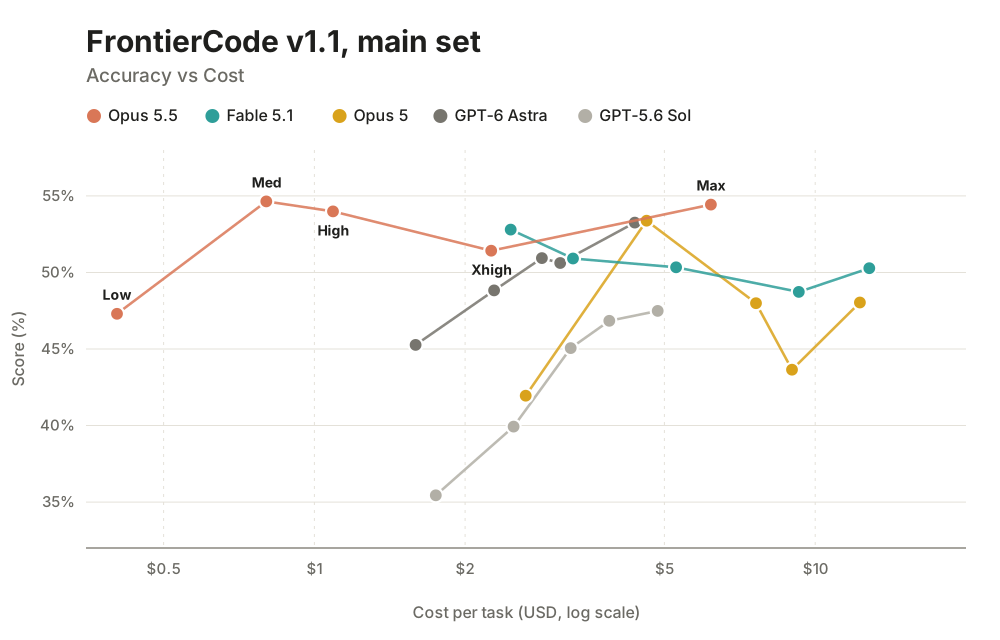
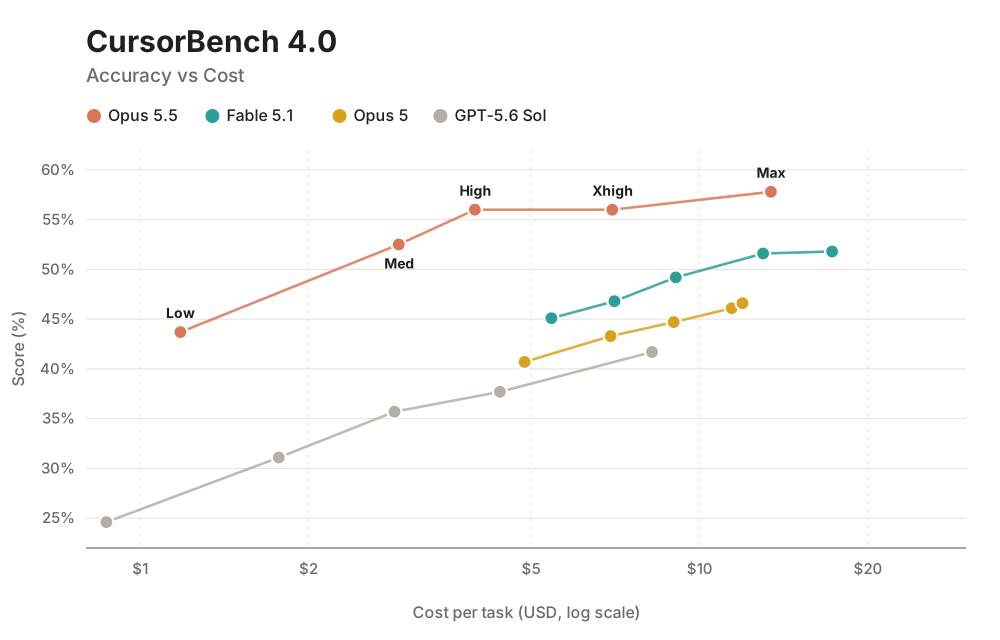
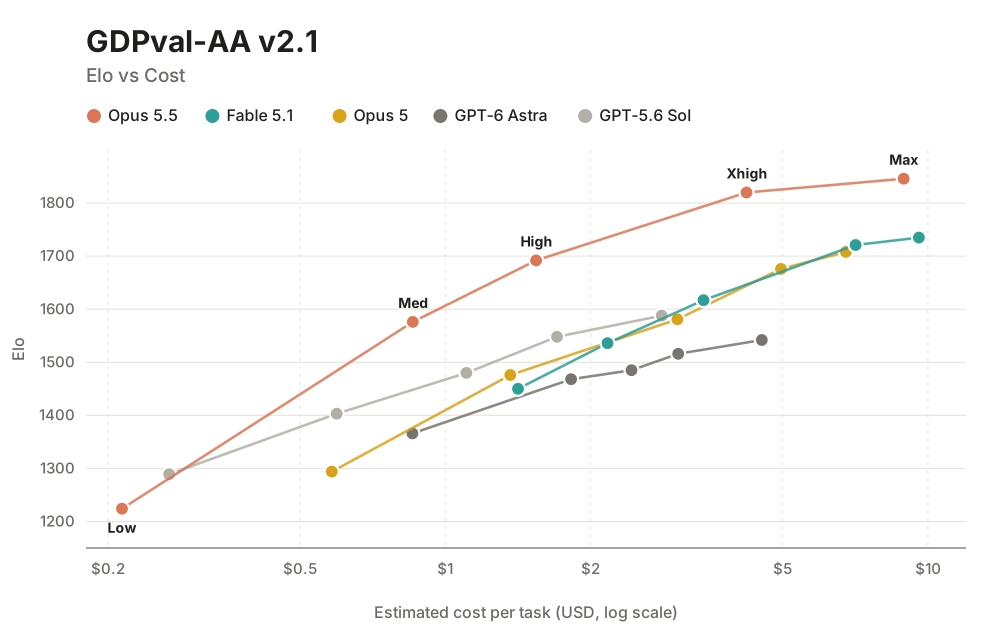
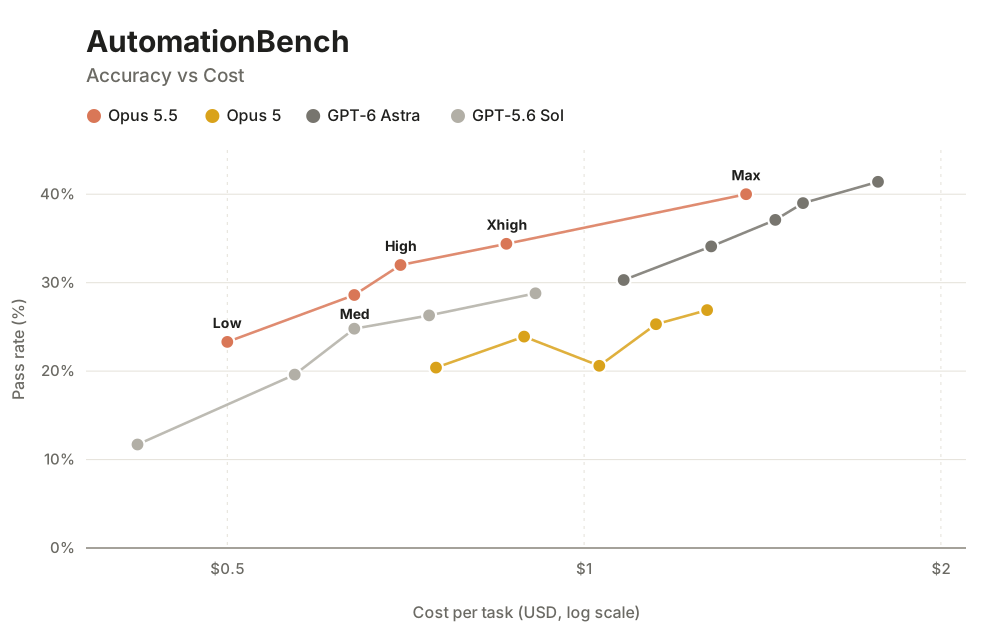
Die Zahlen stammen aus Anthropics Ankündigung vom 22. September. Ich habe sie nicht selbst gemessen. Opus 5.5 läuft hier mit maximalem Effort, bei Terminal-Bench mit Xhigh. Die Diagramme weiter unten habe ich aus denselben Daten neu gezeichnet: dieselben Achsen, dieselben Modellreihen und alle Effort-Stufen von Low bis Max.
Terminal-Bench 4.0: Opus 5.5 mit Xhigh, GPT-6 Astra mit High, beide als jeweils bester Wert; die Werte der OpenAI-Modelle hat OpenAI gemeldet. AutomationBench hat Zapier ausgeführt. Dort zählte jeder Eingriff der Schutzmassnahmen als Fehler, das drückt laut Anthropic das Ergebnis von Opus 5.5.
Kosten gegen Genauigkeit
Jedes Diagramm zeigt pro Modell fünf Punkte, einen je Effort-Stufe. Je weiter links und höher ein Punkt liegt, desto günstiger und besser ist das Ergebnis. Die Kostenachse ist logarithmisch. Die sechs Diagramme liegen als Karteikarten bereit: Wähle oben den Benchmark, der dich interessiert.

Sonnet 5.5 und Haiku 5.5
Sonnet 5.5 kam am 28. September. Es kostet $2 für Input und $10 für Output und liegt in Anthropics Tabelle bei Terminal-Bench 4.0 mit 70,6 % sogar vor Opus 5.5 mit 66,4 %. Das Cache-Lesen kostet seit dem 7. Oktober $0.10 statt $0.20 pro Million Token.
Zudem folgte Haiku 5.5 am 7. Oktober. Es nimmt bis zu 1 Million Token Kontext, rechnet bei Prompts bis 100 000 Token mit $0.10 für Input und $0.50 für Output und kostet damit bei kurzen Prompts ein Zwanzigstel von Sonnet 5.5. Bei der Computernutzung (OSWorld 2.1, Offline-Teilmenge) erreicht es 72,4 %, Haiku 4.5 kam auf 15,7 %. Sonnet 5.5 liegt dort bei 83,9 %.
Fazit
Damit lässt sich die Lage in drei Punkten zusammenfassen. Sie zeigen, was du jetzt prüfen solltest, bevor du Modelle wechselst.
- Wer Opus 5 einsetzt, sollte Opus 5.5 testen. Laut Anthropic ist es günstiger und schneller und braucht weniger Token pro Aufgabe. Die Ersparnis fällt deshalb grösser aus als der reine Preisunterschied.
- Wer die Modell-ID
claude-sonnet-4-5-20250929fest eingetragen hat, muss bis zum 30. November umstellen. - Skripte, die
thinking: disabledoder einen erzwungenen Tool-Aufruf nutzen, können bei den neuen Modellen einen Fehler auslösen.
Daher lohnt ein Blick in den Artikel Robuste KI-Skills statt Modellwissen mit Verfallsdatum: Er zeigt, wie du Abläufe so aufbaust, dass sie nach einem Wechsel des Modells genauso weiterlaufen.
Quellen: Claude Opus 5.5, Claude Sonnet 5.5, Claude Haiku 5.5, Release Notes der Plattform, Release Notes der Claude-Apps und das Changelog von Claude Code. Stand: 16. Oktober 2026. Text und Diagramme habe ich mit Claude Code erstellt und gegen die Originalseiten geprüft.
Recherche und Entwurf KI-gestützt, geprüft und freigegeben von Andreas Brauckmann · So arbeitet die Redaktion
Änderungshistorie
- — Artikel veröffentlicht: fünf Modelle, sechs nachgezeichnete Benchmark-Diagramme von Opus 5.5, Apps, API und Claude Code.