Feste Bildformate wie 1,91:1 für Link-Vorschauen schneiden Motive oft ab. Saliency aus OpenCV findet den Bereich, auf den das Auge fällt, GrabCut stellt das eigentliche Objekt frei. Darauf zentriert wird zugeschnitten; ist das Motiv zu gross, steht es ganz vor einer passenden Füllung. In Link-Vorschauen mit Schrift rückt das Motiv in die Mitte des freien Raums. Eine Nachprüfung meldet Nähte und Streifen.
Ein Hochkantfoto im Breitformat 1,91:1 verliert fast vier Fünftel seiner Höhe. Schneidet ein Programm stur aus der Mitte, bleibt vom Motiv oft nur ein Streifen. Motivbewusster Zuschnitt erledigt das automatisch: Verfahren der KI-Bildverarbeitung suchen zuerst, was das Bild zeigt, und schneiden erst dann.
Das Wichtigste in Kürze
- Das Werkzeug ist frei. OpenCV steht unter der Apache-2.0-Lizenz, das Python-Paket installierst du mit einem Befehl.
- Saliency findet das Motiv. Das Verfahren berechnet eine Karte, wohin das Auge zuerst fällt, ganz ohne trainiertes Modell.
- GrabCut stellt das Objekt frei. Aus dem groben Rahmen wird ein enger Rahmen um Kamera, Gesicht oder Gerät, Finger eingeschlossen.
- Drei Fälle decken fast alles ab. Passt das Motiv, wird darauf zentriert geschnitten. Ist es zu gross, steht es ganz vor einer Füllung.
- Schrift und Motiv teilen sich das Bild. In Link-Vorschauen rückt das Motiv in die Mitte des Raums neben der Schrift.
- Die Endbearbeitung gehört dazu. Der Rand wird in der Farbe des Motivgrunds gefüllt, eine Nachprüfung meldet verbliebene Nähte.
Das Problem mit festen Formaten
Link-Vorschauen auf LinkedIn, in Teams oder in Messengern erwarten ein Querformat um 1,91:1. Vorschaubilder in Listen sind oft quadratisch. Die meisten Systeme lösen das mit einem Schnitt aus der Bildmitte. Bei Landschaften geht das gut. Bei Personen, Geräten oder Hochkantfotos fehlt danach genau das, worum es geht.
Das Bild unten zeigt den Fall. Links schneidet die Mitte aus einem Hochkantfoto einen Streifen heraus: Stirn und Kinn fehlen. Rechts steht dieselbe Maske ganz und mittig, der Rand ist sauber schwarz aufgefüllt.
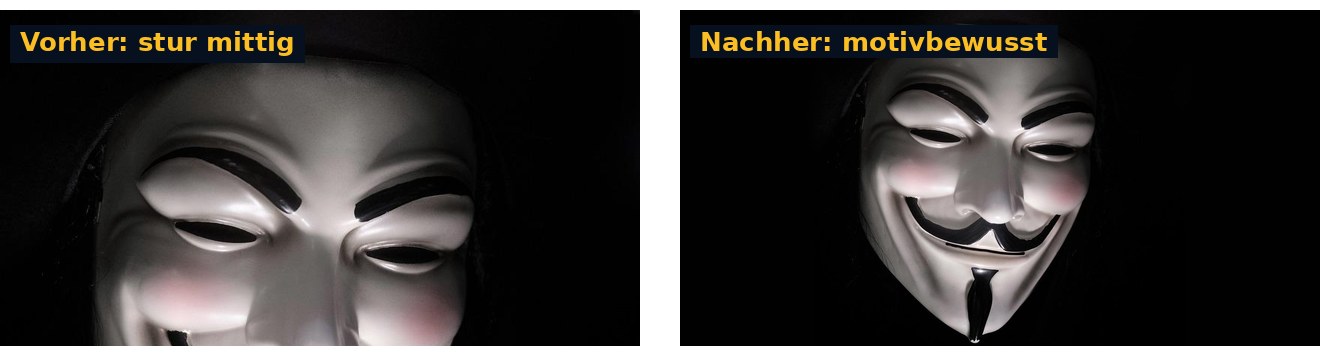 Links der Schnitt aus der Mitte, rechts der motivbewusste Zuschnitt.
Was Saliency misst
Saliency und GrabCut gehören zur Computer Vision, dem Teil der KI, der Bilder auswertet. Beide arbeiten ohne trainiertes Modell und laufen in Sekundenbruchteilen.
Saliency heisst Auffälligkeit. Ein Saliency-Verfahren bewertet jeden Bildpunkt danach, wie stark er sich von seiner Umgebung abhebt. Daraus entsteht eine Karte: helle Stellen ziehen den Blick an, dunkle kaum.
Dafür bringt OpenCV im Zusatzmodul saliency zwei statische Verfahren mit. Spectral Residual geht auf Hou und Zhang (CVPR 2007) zurück und wertet das logarithmische Spektrum des Bildes aus. Fine Grained stammt von Montabone und Soto (2010). Es vergleicht jeden Punkt mit seiner Umgebung und rechnet dank Integralbildern sehr schnell. Daneben kennt das Modul Verfahren für bewegte Bilder und für Objektvorschläge, die hier keine Rolle spielen.
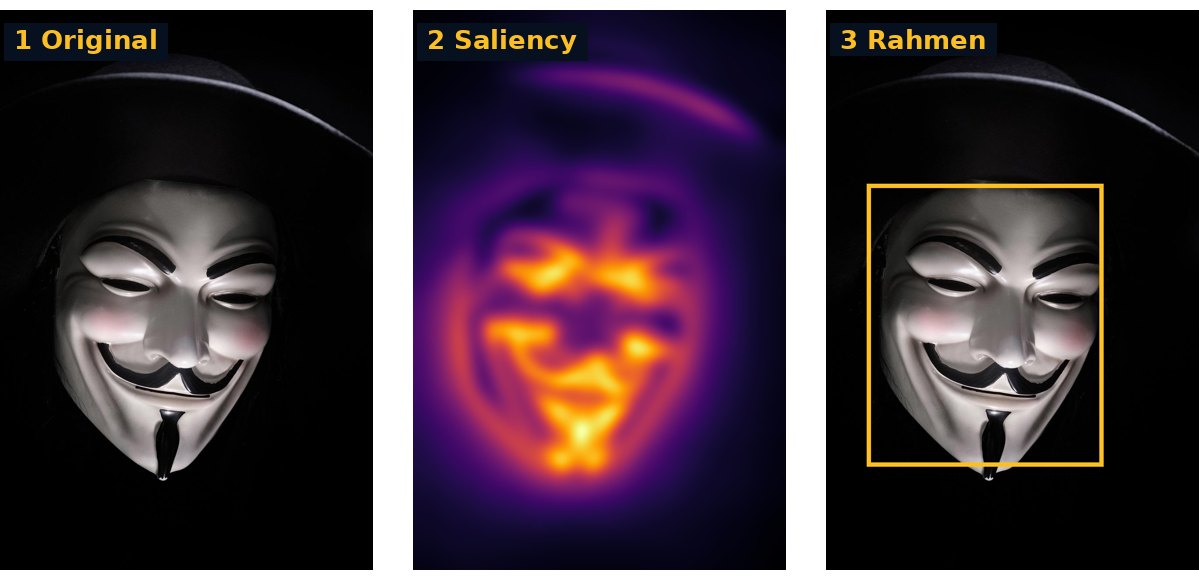 Vom Foto über die Saliency-Karte zum Motivrahmen.
Vom groben Rahmen zum Objekt: GrabCut
Ein Saliency-Rahmen fasst die Auffälligkeit, nicht das Objekt. Je nach Schwelle schneidet er die Hand ab oder nimmt viel Himmel mit. Für das Zuschneiden reicht das. Wer Schrift neben das Motiv setzen will, braucht den genauen Umriss.
Den liefert GrabCut. Das Verfahren stammt von Carsten Rother, Vladimir Kolmogorov und Andrew Blake von Microsoft Research Cambridge. Es bekommt einen Rahmen, der das Objekt sicher enthält, und trennt darin Vordergrund und Hintergrund. Dazu baut es aus den Bildpunkten einen Graphen und schneidet ihn mit einem Min-Cut-Verfahren in zwei Teile. Als Startrahmen dient hier der weite Saliency-Rahmen, als Ergebnis zählt die grösste zusammenhängende Vordergrundfläche.
maske = np.zeros(bild.shape[:2], np.uint8)
cv2.grabCut(bild, maske, rahmen, np.zeros((1, 65)), np.zeros((1, 65)), 4, cv2.GC_INIT_WITH_RECT)
vorne = np.where((maske == 1) | (maske == 3), 255, 0).astype(np.uint8)
n, _, werte, _ = cv2.connectedComponentsWithStats(vorne)   # groesste Flaeche = das Objekt
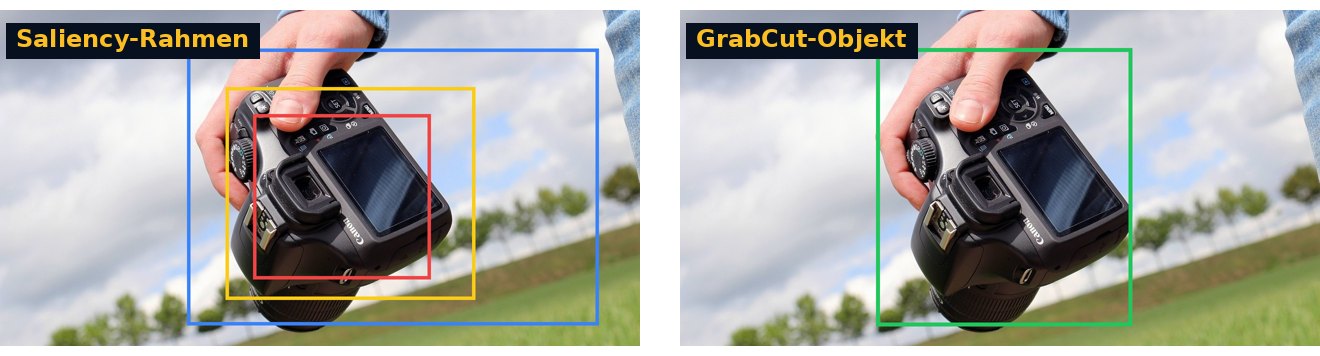 Saliency-Rahmen je nach Schwelle (links) und der GrabCut-Rahmen um das Objekt (rechts).
Installation
Das Modul liegt im Contrib-Paket. Für Server ohne Bildschirm gibt es eine Fassung ohne Grafikbibliotheken:
pip install opencv-contrib-python-headless
Die aktuelle Version 5.0.0.93 erschien am 2. Juli 2026, OpenCV 5.0.0 selbst am 6. Juni 2026. Das Paket läuft auch auf ARM-Rechnern ohne eigene Kompilierung.
Der Kern in Python
Zuerst entsteht die Karte auf einer verkleinerten Fassung des Bildes. Danach sucht der Code den Rahmen, der rund 90 Prozent der Auffälligkeit enthält. So stören einzelne helle Punkte am Rand nicht.
import cv2, numpy as np

def motiv(bild):                      # bild: BGR-Array, max. 400 px
    ok, karte = cv2.saliency.StaticSaliencyFineGrained_create().computeSaliency(bild)
    karte = cv2.GaussianBlur(karte.astype("float32"), (0, 0), 6)
    karte[karte < np.percentile(karte, 60)] = 0

    def spanne(profil):
        c = np.cumsum(profil) / profil.sum()
        return np.searchsorted(c, 0.05), np.searchsorted(c, 0.95) + 1

    x0, x1 = spanne(karte.sum(axis=0))
    y0, y1 = spanne(karte.sum(axis=1))
    return x0, y0, x1, y1
Damit ist das Motiv gefunden. Den eigentlichen Schnitt entscheidet ein zweiter Schritt.
Drei Fälle beim Zuschneiden
| Fall | Vorgehen | Was der Leser sieht |
|---|---|---|
| Motiv passt in den Ausschnitt | Ausschnitt auf die Mitte des Motivs legen | Das Motiv mittig, mit Luft rundherum |
| Motiv ragt bis 25 % hinaus | Trotzdem zentriert schneiden | Ein knapp angeschnittener Rand, dafür keine Ränder im Bild |
| Motiv ist deutlich grösser | Motiv ganz zeigen, Rest auffüllen | Das ganze Motiv, links und rechts eine ruhige Fläche |
Beim dritten Fall entscheidet die Füllung über die Wirkung. Ist der Rand des Motivs einfarbig, etwa ein schwarzer Hintergrund, füllt der Code mit genau dieser Farbe auf. Sonst nimmt er eine weichgezeichnete, abgedunkelte Fassung desselben Fotos. In beiden Fällen läuft die Naht über einen weichen Übergang.
Die Endkontrolle wie beim Bildbearbeiter
Zum Ablauf gehört ein letzter Durchgang über das fertige Bild. Ein Bildbearbeiter achtet hier auf graue Streifen neben einem schwarzen Motiv oder auf sichtbare Kanten der Füllung. Genau das prüft der Code. Er sucht Kanten, die fast über die ganze Bildhöhe in dieselbe Richtung springen, und auf einer Seite glatt sind.
Die zweite Bedingung trennt Nähte von echten Kanten. Serverschränke, Regale oder Türblätter haben auf beiden Seiten Struktur und bleiben unbeanstandet. Übrig bleiben Nähte von Füllungen und Weichzeichnungen. Diese Hinweise gehen an einen Menschen, der das Bild ansieht und entscheidet.
Schrift und Motiv in der Link-Vorschau
Link-Vorschauen tragen oft Schrift im Bild: eine Schlagzeile und einen Knopf. Liegt die Schrift auf dem Motiv, verliert beides. Ein Bildbearbeiter rückt das Motiv deshalb in die Mitte des freien Raums. Steht der Text links, reicht dieser Raum vom Ende der Schrift bis zum rechten Rand. Er wird halbiert, dort sitzt die Mitte des Objekts.
Genau so arbeitet auch der Code. Er misst die tatsächliche Fläche der Buchstaben und des Knopfs, nicht die Breite des Textkastens. Danach vergrössert er das Foto um höchstens 35 Prozent und verschiebt es, bis die GrabCut-Mitte im freien Raum liegt. Reicht das Foto auf der Schriftseite nicht, läuft es dort weich in eine weichgezeichnete Fassung desselben Bildes aus. Zum Schluss misst er, wie viel vom Objekt die Schrift noch verdeckt.
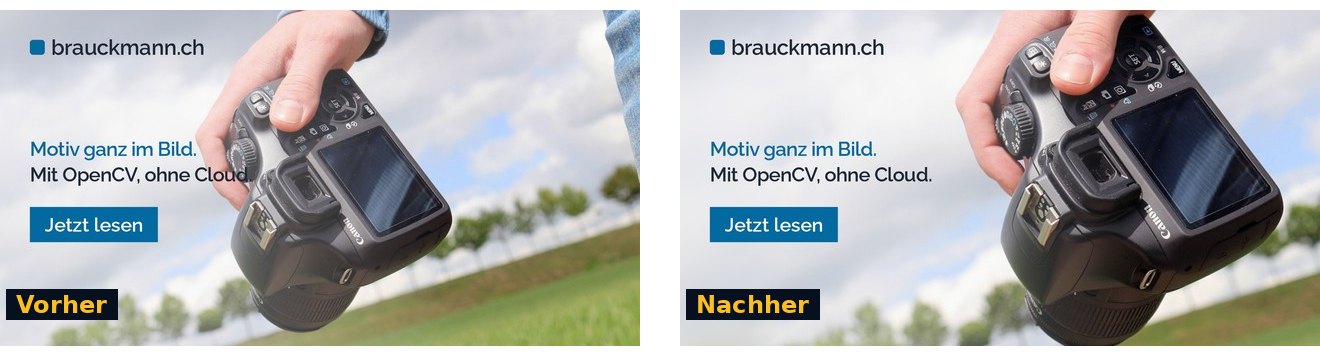 Vorher reicht der Finger in die Schrift, nachher steht die Kamera mittig im freien Raum.
Grenzen des Verfahrens
Saliency misst Kontrast, keine Bedeutung. Steht ein Schriftzug grell im Hintergrund, zieht er den Rahmen an sich. Bei zwei gleich starken Motiven liegt die Mitte womöglich dazwischen. Gesichter erkennt ein eigener Detektor zuverlässiger.
Daher bleibt der letzte Blick Pflicht. Das Verfahren erledigt den Normalfall und markiert die Ausnahmen. Wer viele Fotos aus Bilddatenbanken verwendet, etwa lizenzfreie Fotos von Pixabay, spart damit trotzdem den grössten Teil der Handarbeit.
Fazit
Motivbewusster Zuschnitt braucht keine Cloud und kein trainiertes Modell. Saliency findet das Motiv, GrabCut stellt das Objekt frei, und drei einfache Regeln schneiden es sauber aus. In Link-Vorschauen rückt das Motiv neben die Schrift, eine Nachprüfung findet Nähte. Als nächsten Schritt lässt du den Code über deine vorhandenen Vorschaubilder laufen und vergleichst Vorher und Nachher.
Quellen: OpenCV-Contrib, Modul saliency, opencv-contrib-python-headless auf PyPI, OpenCV 5.0.0 auf GitHub, OpenCV-Anleitung zu GrabCut. Foto: JESHOOTS-com / Pixabay. Stand: 17. Oktober 2026.
Recherche und Entwurf KI-gestützt, geprüft und freigegeben von Andreas Brauckmann · So arbeitet die Redaktion
Änderungshistorie
- — Artikel veröffentlicht.